DocXtrans Header
ISO9001 Logo
TISAX Logo

DocXtrans · IDP-Engine

Trainiert mit Ihren Dokumenten

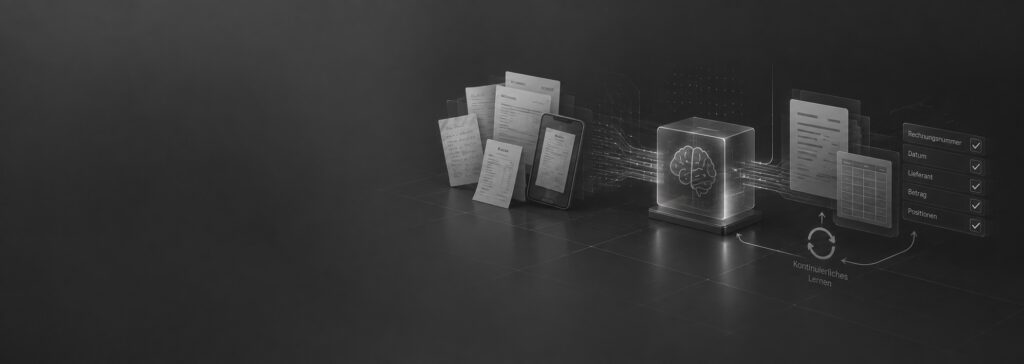
Unleserliche Handschriften, komplexe Tabellen, schräg fotografierte Belege. DocXtrans trainiert mit Ihren eigenen Dokumenten und optimiert sich und Ihre Prozesse fortlaufend. Wie viel davon ohne manuellen Eingriff läuft, legen Sie selbst fest.

100%

automatisierte Vorgänge im Referenzeinsatz

nahezu 100 %

Erkennungsquote, abhängig vom eingestellten Threshold

> 60.000

Dokumente pro Arbeitstag


Ihre Vorgabe

Anteil der Dunkelverarbeitung, einstellbar nach Compliance


Referenzeinsatz

Im Einsatz bei der Nummer 2 in Europa.

Stellantis setzt DocXtrans seit mehr als 10 Jahren ein. Die Engine erfasst dort unter kontinuierlicher Weiterentwicklung alle dokumentenbasierten Vorgänge über die gesamte Breite eines herstellerweiten Händlernetzes.
DocXtrans Inhalt

Belegverarbeitung im Hersteller-Händler-Verhältnis: Erfassung, Klassifikation und Prüfung laufen ohne manuelle Vorsortierung.

Stellantis stellantis.com →
Stellantis auf einen Blick
Marktposition
Nr. 2 im europäischen Markt (EU30) mit rund 16 % Marktanteil (2025)
Markenportfolio
14 Fahrzeugmarken unter einem Konzerndach
Volumen
rund 5,4 Mio. weltweit ausgelieferte Fahrzeuge (2025), bei einem EU30-Gesamtmarkt von rund 15,1 Mio. Neuzulassungen
Umsatzgrößenordnung
Konzernumsatz im dreistelligen Milliarden-Euro-Bereich

Öffentliche Eckdaten aus Geschäftsbericht und Pressemitteilungen von Stellantis, Geschäftsjahr 2025.

Abgedeckte Dokumentenströme

Die Engine erfasst und klassifiziert die Belege über die volle Breite des Hersteller-Händler-Verhältnisses.

  • alle Verkäufe, einschließlich Leasing und Finanzierung
  • Verkaufsförderungsmaßnahmen und Promotions
  • Bonusabrechnungen
  • Garantie und Kulanz
  • Rückrufe (Recalls)

So funktioniert DocXtrans

Erkennen, verarbeiten und lernen.

Kernfähigkeiten

Vier Ebenen, die ineinandergreifen.

Intelligente Datenextraktion
Text, Handschrift und Zonen in einem Schritt erkannt

Erkennung — Druck, Handschrift, Barcodes und Markierungen, layoutunabhängig und scan-invariant


Zonen — Tabellen, Unterschriftsfelder sowie Ausweis-, Kfz- und Formularbereiche gezielt ausgewertet


Bildaufbereitung — automatische Schräglagenkorrektur und Handhabung unterschiedlicher Datumsformate


Template-Masken — optional für layout-feste Dokumente, zur formellen und inhaltlichen Kontrolle

Deep Learning
Automatische Typerkennung, unabhängig von Layout oder Format

Typerkennung — Rechnung, Vertrag oder Nachweis unabhängig von Layout und Format, inklusive Inhalten wie Beträgen und Namen


Klassifikation — regelbasiert und häufigkeitsgewichtet über konfigurierbare Merkmale und Ersatzgruppen


Verfahren — deterministisch-regelbasiert, lernend oder als Kombination beider Ansätze konfigurierbar


Ignore-Listen — dynamisch gepflegt für Händler- und Objektdaten

Kontinuirliches Lernen
Abgleich gegen Referenzdaten mit Erkennungssicherheit

Referenzabgleich — definierte Prüfwerte lokalisiert und gegen hinterlegte Daten abgeglichen, auch in Fremdsystemen


Level of Trust — getrennt je Dokument und je Identifier statt eines vermischten Gesamtscores


Dreiecksmethode — Positions- und Originalitätsprüfung mit frei wählbaren Toleranzen


Threshold — von Ihnen eingestellt; steuert, was dunkel verarbeitet wird und was zur manuellen Prüfung geht

Templatematching, POST-Recognition und Character Replacement für präzise OCR/ICR
Strukturiert per API an Ihre Systeme übergeben

REST-API — Übergabe einzelner Werte und Strings oder ganzer Dokumente


Zielsysteme — offen für ERP, CRM oder jede weitere Anwendung


Formate — durchsuchbare Ausgabe als PDF, PDF/A, DOCX, XML und XPS; E-Rechnungen (ZUGFeRD, XRechnung) strukturiert ausgelesen


Betrieb — Cloud-SaaS, gehostet in Deutschland

E-Rechnung

Papier, PDF und E-Rechnung in einem Eingang.

Mit der E-Rechnungspflicht laufen strukturierte und bildhafte Rechnungen über Jahre parallel. DocXtrans verarbeitet alle Wege und übergibt einheitliche Werte an Ihre Systeme.

Papier & Bild-PDF

Per Texterkennung gelesen

Gescannte Belege und PDF-Rechnungen ohne strukturierte Daten werden über OCR und ICR gelesen, klassifiziert und extrahiert.

ZUGFeRD

Eingebettetes XML ausgelesen

Das hybride Format verbindet eine PDF-Ansicht mit XML-Rechnungsdaten. DocXtrans übernimmt die XML-Werte direkt, ohne Texterkennung.

XRechnung

Reines XML direkt übernommen

XRechnungen enthalten ausschließlich strukturierte Daten. DocXtrans übernimmt die Werte direkt und prüft sie wie jeden anderen Eingang.

Einheitliche Übergabe

Ein Datensatz, gleich welcher Eingang

Alle Wege durchlaufen dieselbe Verifikation mit Level of Trust und gehen im selben Format per REST-API an ERP, DMS und Archiv.

GEDAK als Partner

Betrieb, Sicherheit und Zusammenarbeit.

DocXtrans ist eine Individualentwicklung von GEDAK. Wir entwickeln die Lösung, betreiben sie und begleiten sie über den Go-live hinaus.

Betrieb in Deutschland

Cloud-SaaS in deutschen Rechenzentren, Übertragung über HTTPS, verschlüsselte Speicherung, Zugriff über SSO mit 2-Faktor-Authentifizierung.

Datenminimierung ab dem Upload

Clientseitige Schwärzung im Browser reduziert das Originaldokument, bevor es den Arbeitsplatz verlässt.

Individualentwicklung statt Standardprodukt

Über 40 Jahre Erfahrung in der Entwicklung von Fachanwendungen. DocXtrans wird auf Ihre Dokumententypen und Prozesse zugeschnitten.

Begleitung über den Go-live hinaus

Von der Bedarfsanalyse über die Umsetzung durch ein festes Team bis zum laufenden Betrieb und der Weiterentwicklung.

ISO 9001 TISAX EcoVadis Silber ISO 27001 in Vorbereitung DSGVO-konform

Prinzip

Ergänzt, optimiert und orchestriert.

DocXtrans löst kein Bestandssystem ab. Die Engine arbeitet als neutrale Schicht zwischen Ihren vorhandenen Anwendungen.

Eingang
Scan & Papier offline E-Mail online Foto & Mobile Capture unterwegs erfasst API / Schnittstelle aus Bestandssystemen
DocXtrans
Neutrale Erkennungsschicht
lesenklassifizierenextrahierenverifizieren
Dunkelverarbeitung Human-in-the-Loop · bei Bedarf Deterministische Verifikation
Zielsysteme
ERP strukturierte Werte DMS & Archiv Dokument & Metadaten CRM strukturierte Werte Workflow & Fachanwendung Vorgangsdaten

Häufige Fragen

DocXtrans kurz erklärt.

Was ist der Unterschied zwischen OCR, ICR und IDP?

OCR (Optical Character Recognition) wandelt gedruckten Text aus Bilddateien in maschinenlesbaren Text um. ICR (Intelligent Character Recognition) erweitert dies auf handschriftliche Zeichen. IDP (Intelligent Document Processing) klassifiziert das Dokument zusätzlich, erkennt Zonen und Felder, extrahiert die relevanten Werte und überführt sie strukturiert in Folgeprozesse. DocXtrans deckt alle drei Ebenen ab und ergänzt sie um Klassifikation, Verifikation und Level of Trust.

Welche Dokumententypen erkennt DocXtrans?

DocXtrans erkennt unter anderem amtliche Formulare, Ausweise, Kfz-Unterlagen und Handelsrechnungen sowie Dokumentinhalte wie Tabellen, Schlüsselangaben und Unterschriften. E-Rechnungen im Format ZUGFeRD oder XRechnung werden über ihre XML-Daten strukturiert ausgelesen statt per Texterkennung. Zusätzlich zu OCR und ICR arbeitet die Engine mit OMR, Barcode- und Formularerkennung sowie automatischer Zonenerkennung und unterstützt Ausgabeformate wie PDF, PDF/A, DOCX, XML und XPS.

Was bedeuten Dunkelverarbeitung, Level of Trust und Threshold?

Dunkelverarbeitung heißt: Ein Dokument durchläuft Erkennung, Extraktion und Verifikation ohne manuellen Eingriff. Der Level of Trust gibt die Erkennungssicherheit getrennt je Dokument und je Identifier an. Der Threshold ist der Schwellenwert, den Sie festlegen: Liegt der Level of Trust darüber, wird das Dokument dunkel verarbeitet, liegt er darunter, geht es zur manuellen Prüfung. So steuern Sie den Anteil der Dunkelverarbeitung nach Ihrer Compliance-Vorgabe.

Wo wird DocXtrans betrieben und ist es DSGVO-konform?

DocXtrans steht als Cloud-SaaS zur Verfügung und wird DSGVO-konform in Deutschland betrieben. Die Übertragung erfolgt über HTTPS, Daten werden verschlüsselt gespeichert, der Zugriff ist über SSO mit 2-Faktor-Authentifizierung abgesichert. Durch clientseitige Schwärzung im Browser lässt sich das Originaldokument bereits vor dem Upload minimieren. GEDAK ist nach ISO 9001, TISAX und EcoVadis (Silber) zertifiziert. ISO 27001 ist in Vorbereitung.

Lässt sich DocXtrans an eigene Dokumente anpassen und wie startet ein Projekt?

Ja. DocXtrans ist eine Individualentwicklung von GEDAK und wird über konfigurierbare Merkmale, Ersatzgruppen, Template-Masken und Toleranzen an Ihre Dokumente und Prozesse angepasst. Ein Projekt startet mit einer Bedarfsanalyse: Wir sichten Ihre Dokumententypen und Prozesse und leiten daraus einen konkreten Pilot ab. GEDAK begleitet die Lösung über den Go-live hinaus.

Passt DocXtrans zu Ihren Dokumentenprozessen?

In einer kurzen Bedarfsanalyse sichten wir Ihre Dokumententypen und Abläufe und leiten daraus einen konkreten Pilot für die automatische Erkennung und Datenextraktion ab.

Bedarfsanalyse anfragen

oder direkt: +49 2152 9940-0 · info@gedak.de